こんにちは、大人の競馬場コンシェルジュのYUKINOSUKEです。
最近、ネットやSNS、あるいはYouTubeなんかを開くと、「競馬 ai」とか「最新のAI予想で帯封ゲット!」といった景気のいい言葉、本当によく見かけませんか?
世間はすっかりAIブーム。ChatGPTなどの生成AIが登場して以来、競馬の世界にもものすごい勢いでデータサイエンスの波が押し寄せてきていますよね。
「最新のAIを使えば、今まで外れまくっていた馬券が簡単に当たるようになるのかな?」
「競馬新聞のベテラン記者の印を見るより、AIに予想を丸投げしたほうが確実に儲かるかも!」
なんて、少しワクワクした期待を持ってこの記事にたどり着いたあなた。
その気持ち、めちゃくちゃよくわかりますよ。私も20代の頃、自分の当たらない予想にすっかり嫌気がさして、「誰か(あるいは何か)絶対に当たる魔法の法則を教えてくれ!」って、夜な夜なネットの海を彷徨い歩いた経験がありますから(笑)。
でも、いざ「AI競馬予想の仕組み」を自分で調べようとすると、いきなり「機械学習」だの「アルゴリズム」だの「損失関数」だの、専門用語や数式ばかりがズラッと並んでいて、開始3分でチンプンカンプンになってページを閉じてしまう……なんてことも多いですよね。
そこでこの記事では、競馬予想aiが一体どうやって「買いの馬」を選んでいるのか、裏側でどんな競馬 データ分析を行っているのか、そして、私たち競馬ファンがこの強力なAI予想とどう付き合っていくべきかについて、文系出身の初心者の方にもスッと腹に落ちるように、徹底的に分かりやすく解説していきます。
最後までじっくり読んでもらえれば、あなたの競馬ライフは、ただお金が減っていくだけの「運任せのギャンブル」から完全に卒業し、論理的でエキサイティングな「知的パズル」へと劇的に進化しますよ。さあ、一緒にデータ競馬の深い世界へ潜っていきましょう!
💡 この記事であなたが手に入れる「4つの武器」
- 競馬予想AIの根本的な仕組みと、AIが食べている「データ」の正体
- 初心者が絶対に陥るワナ。的中率ではなく「回収率」を最重視すべき数学的な理由
- 業界標準の最強アルゴリズムと呼ばれる「競馬 lightgbm」の凄さと驚くべき特徴
- AIを「神様」ではなく「優秀な相棒」として使いこなすための資金管理とメンタル術
競馬AI予想とは?仕組みを基礎から解説
ここではまず、競馬AI予想の根本的な「思考回路」についてお話ししていきますね。
AIがどんな情報をベースにして予想を組み立てているのかを知ることで、今まで謎に包まれていたAIのブラックボックスが、少しずつ透明なガラス張りに見えてくるかなと思います。
膨大な過去レースデータが予測の基盤
長く競馬を楽しんできた方の中には、「パドックで首をリズムよく振って元気だったから」とか、「今日は大好きな武豊ジョッキーが乗るから応援馬券で!」というような、人間の直感や経験則、あるいは「好き嫌い」で馬券を買っている方も多いかもしれません。
もちろん、趣味として競馬を楽しむならそれも大正解です。競馬場でのビールと直感馬券、最高ですよね。
でも、本気で勝ちに行こうとする競馬 ai 予想は、そういった人間の主観的なバイアス(思い込みや偏見)を完全に、そして冷徹に排除します。
私たち人間の脳みそって、実はすごくポンコツにできているんです。「ルメール騎手を買っておけば当たる!」と思い込んでいると、ルメール騎手が勝ったレースばかりを強く記憶してしまい、飛んで(負けて)馬券が紙くずになったレースのことは無意識に忘れてしまうんですね。これを心理学で「確証バイアス」と呼びます。
AIは事実だけを淡々と飲み込み続ける
一方、AIの予想のベースになっているのは、人間の曖昧な記憶ではありません。JRA(日本中央競馬会)の公式データベースなどから提供される、過去数十年分にも及ぶ膨大なレース結果や、競走馬の細かい属性データそのものです。
過去に行われた何万、何十万というレースの「走破タイム」「上がり3ハロンの時計」「血統(種牡馬や母父)」「レースごとの馬体重の増減」「当日の天候」「芝の含水率」「クッション値」といった、誰も否定できない客観的な数字だけを学習用データとして読み込ませるんですね。
人間の頭では、過去10年分のすべてのレース映像を記憶して比較することなんて到底不可能ですよね。でもAIなら、スーパーコンピュータの演算能力を使って一瞬で読み込み、そこから「人間が認知し得ない複雑な相関関係」や「特定の馬場状態と血統が組み合わさった時だけ激走するパターン」を自動的に見つけ出してくれます。
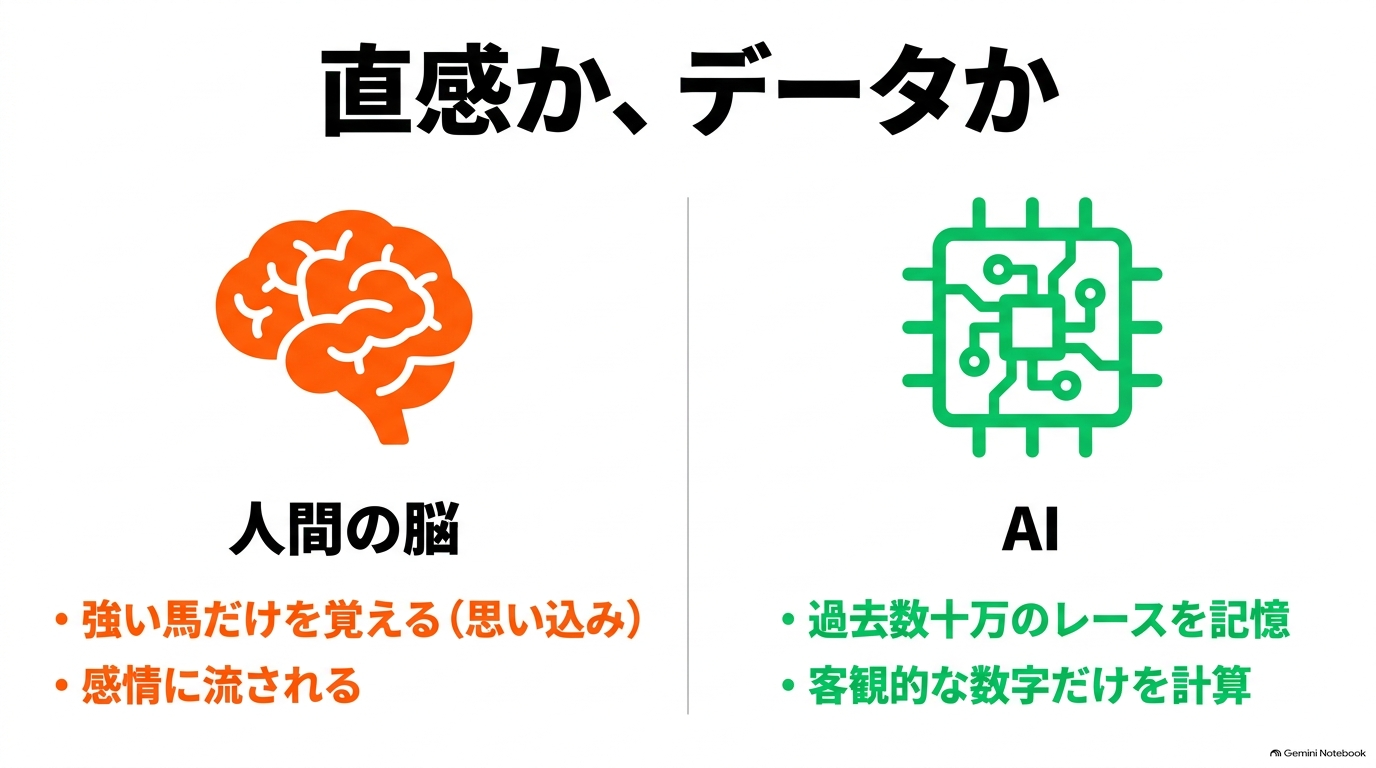
人間の思い込みと競馬AIの客観的なデータ処理の比較
つまり、競馬AIが目指しているのは、「なんとなく強そうな馬を直感で探す」ことでは決してなく、「データという確固たる裏付けをもとに、過去数十万回の統計から最も確率の高い最適解を導き出す」ことなんです。
的中率ではなく回収率を重視する
競馬をやっていると、どうしても「今日は何レース当たったか」「どれだけ的中するか」という『的中率』ばかりに目が行きがちですよね。
競馬新聞に◎(本命印)がたくさんついている馬が勝つと、「やっぱり順当に決まったか」と安心する。その気持ちもわかります。
でも、競馬予想aiの仕組みを正しく理解し、投資として競馬を成立させる上で、この「的中率至上主義」は今日、この瞬間からゴミ箱に捨てていただきたいんです。
的中率80%でも「破産」する競馬のリアル
少し極端な例を出しますね。
毎レース、オッズが1.1倍〜1.2倍になるような圧倒的な1番人気の馬の「複勝(3着以内に入る馬券)」だけを買い続けたとします。アーモンドアイやイクイノックスのような歴史的名馬ばかりを狙う買い方ですね。
これをやれば、AIなんていう高度なテクノロジーを使わなくても、50%から80%くらいの高い的中率を叩き出すことは人間にも簡単にできちゃいます。
「おっ、8割も当たるならめっちゃ儲かるじゃん!」と思いましたか?
残念ながら、答えは圧倒的な「NO」です。絶対に資金はパンクします。
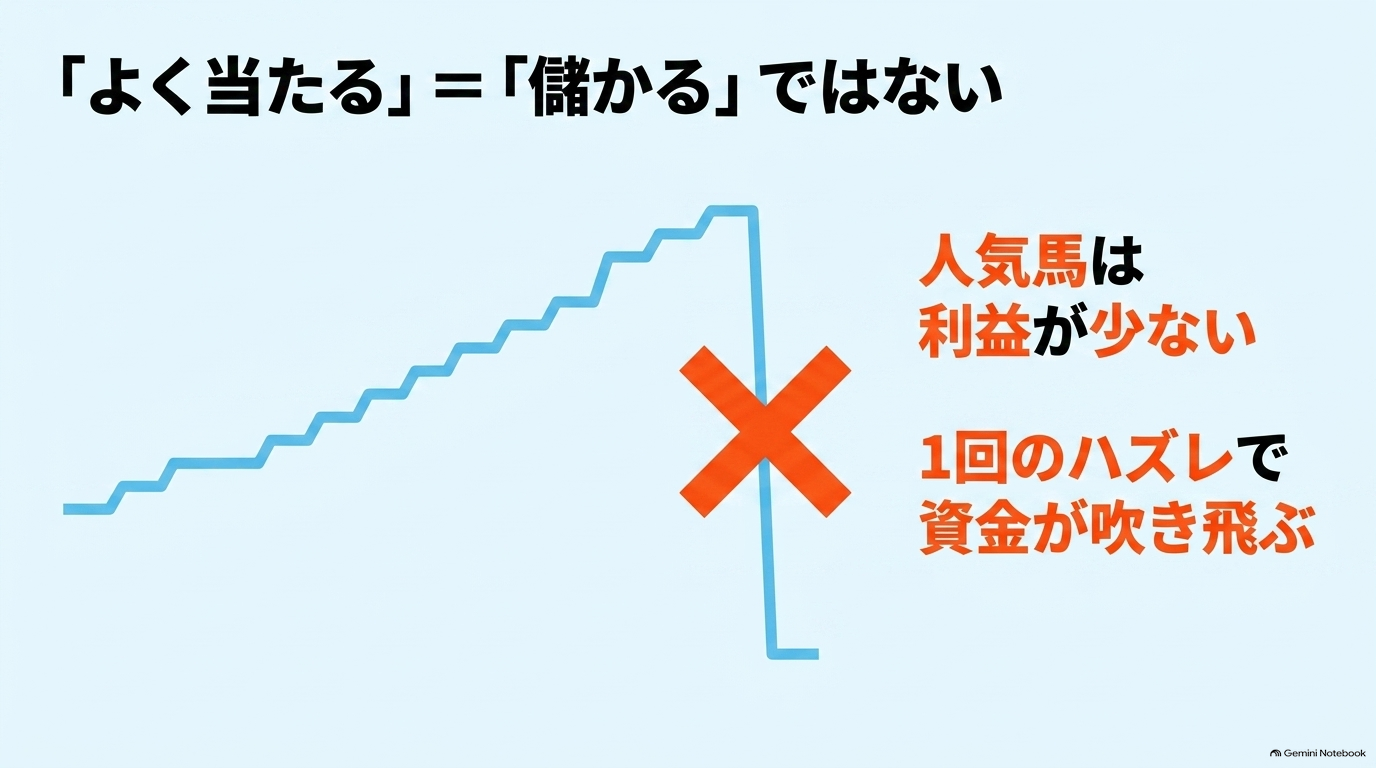
的中率が高くても人気馬ばかりを買うと1回のハズレで資金が吹き飛ぶリスク
人気馬は、多くの人が買うためオッズが極端に低く設定されています。100円買っても110円にしか増えません。もし1回でも着外(4着以下)に飛んでしまったら、それまでコツコツ積み上げてきた数十円の利益が、たった1回の不的中で一気にマイナスに転落してしまいます。
いくらたくさん的中させても、長期的に見れば回収率(投資したお金に対する払い戻しの割合)は75%から90%くらいに落ち着いてしまい、確実に、そして静かにあなたのお財布からお金は減っていくんです。
AIが見つけるのは「妙味(期待値)」
私たちが目指すべきは、ビジネスの投資(ROI:投資利益率)と全く同じで、「長期的なトータルの回収率を100%以上に保つこと」ですよね。
優秀な競馬 aiは、大衆の評価によって作られた「市場のオッズ」と、AI自身が緻密なデータ分析から計算した「真の勝率」とを、感情を一切交えずに天秤にかけます。
そして、「AIの計算では勝率が20%(本来なら単勝5倍が適正)もあるのに、世間の人は見落としていて単勝オッズが15倍もついている馬」を発見します。
これこそが、オッズに対して過小評価されている期待値の高い馬(通称:妙味馬、バリュー馬)です。
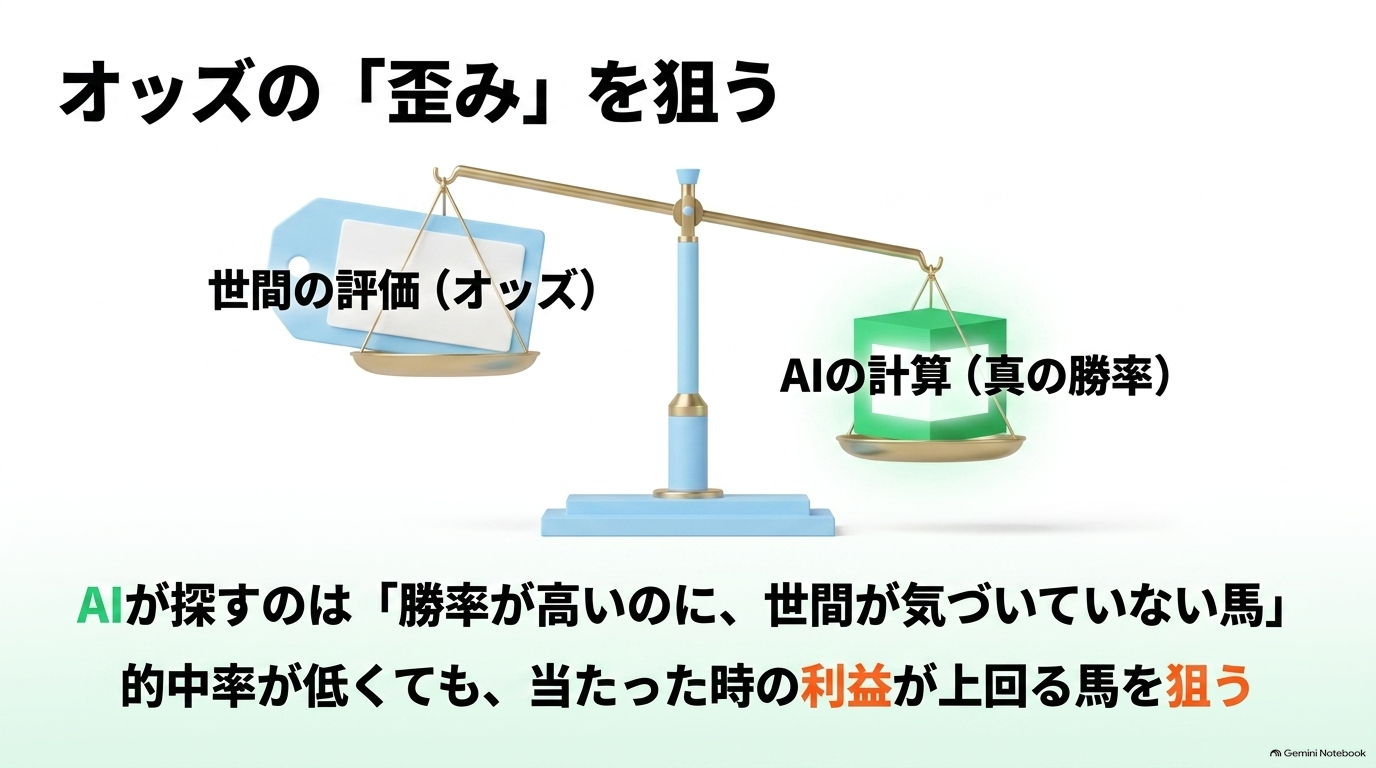
世間の評価であるオッズとAIが計算した真の勝率のバランス
AIは、たとえ的中率が10%や20%に下がろうとも、当たった時のリターンがリスクを大きく上回る「期待値が100%を超える馬」だけを機械的かつ冷徹に抽出し続けます。ここが、ただの運試しではなく、投資としての競馬を成立させる一番の心臓部なんですよ。
控除率の壁を越えるための仕組み
競馬を長年やっていて、「年間トータルでプラス収支になっている」という人は、競馬ファン全体のわずか数パーセントしかいないと言われています。
なぜ勝つことがそれほどまでに難しいのか。あなたも薄々は感じているかもしれませんね。
その最大の原因にして最大の障壁が、競馬というギャンブルの構造そのものである「控除率(テラ銭)」の存在です。
パリミュチュエル方式とは?
日本のJRA(日本中央競馬会)や地方競馬では、「パリミュチュエル方式」というオッズ計算システムが採用されています。
これは、私たちファンが馬券を買って集まった「売上の総額」から、まず主催者側(JRA)の取り分である「控除率」を天引きし、残ったお金を的中者全員で分配するという仕組みです。
この控除率は馬券の種類によって多少異なりますが、概ね20%から30%に設定されています。(単勝や複勝は20%、三連単は約27.5%など)。
この集められたお金(国庫納付金など)は、国の畜産振興や社会福祉事業、インフラ整備などに役立てられているため、非常に公的な意義があるシステムです。 (出典:農林水産省『競馬』)
ただ、馬券を買う側のプレイヤー視点でシビアに考えると、これはとんでもないハンデキャップなんです。
100円の馬券を買った瞬間、その価値は自動的に75円前後まで下がっているわけですからね。つまり、市場に参加している全プレイヤーの平均回収率は、何もしなくても必然的に70%〜80%の間に収束していく運命にあります。
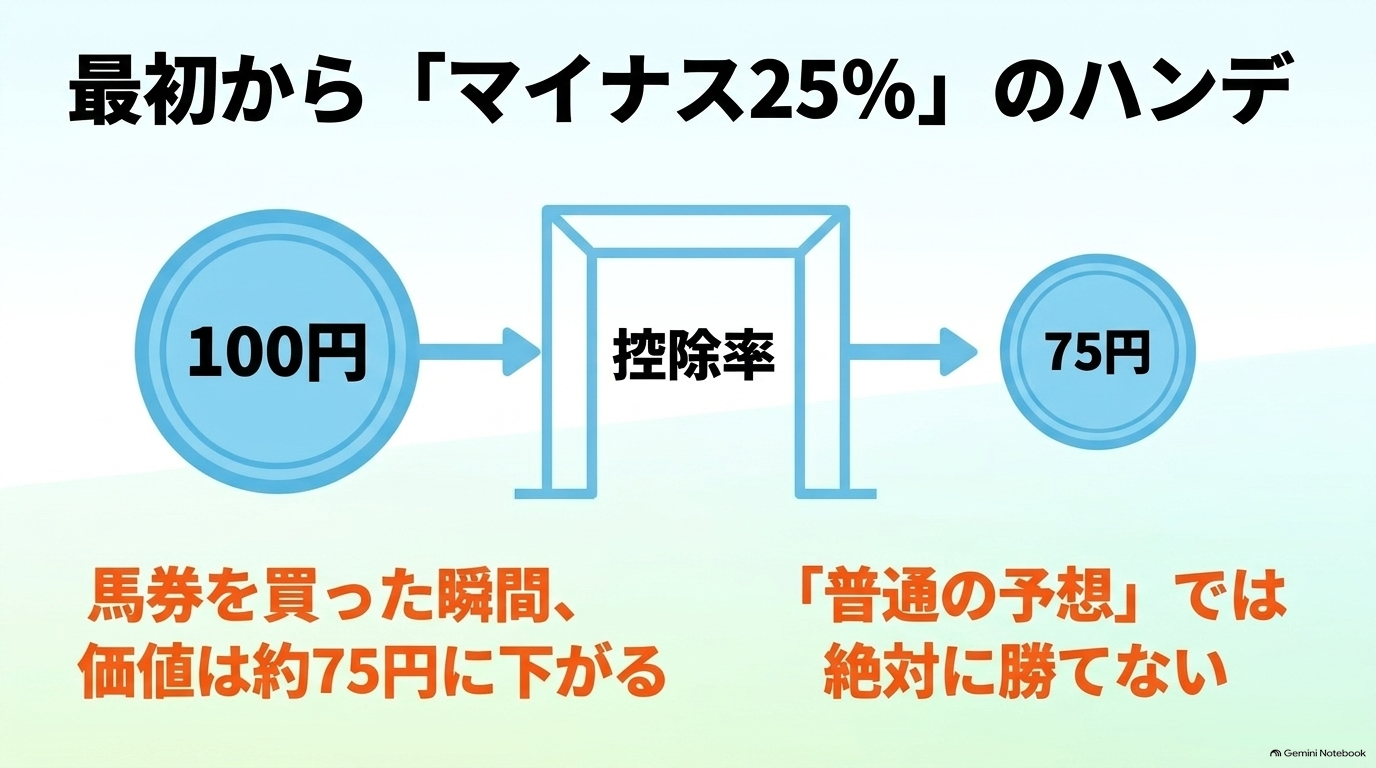
馬券を買った瞬間から引かれる競馬の控除率の仕組み
控除率の壁を舐めてはいけない
競馬予想AIをシステムとして運用し、継続的に利益を出すためには、単に「そこそこ当たる(平均的な予想ができる)」レベルでは全くお話になりません。
最初からマイナス20〜30%のハンデを背負った状態からスタートして、さらに100%のラインを突破しなければならないからです。この分厚い控除率の壁を確実にひっくり返せるだけの、圧倒的な優位性(エッジ)を持った予想モデルの構築が求められます。
だからこそ、AIはテレビやスポーツ紙がこぞって推奨するような「みんなが買っている本命馬」には手を出さず、人が見落としがちな中穴〜大穴馬を狙い撃ちにして、オッズの歪みを突くアービトラージ(裁定取引)を行おうとするわけです。
競馬データ分析が予想AIを支える
さて、ここからは、AIの頭脳の中身とも言える競馬 データ分析の具体的な手法について、さらに一段深く掘り下げて見ていきましょう。
どんなに賢い最新の大規模言語モデル(LLM)や高度なアルゴリズムを用意しても、AIに教える「データ」が適当なら、出てくる答えも適当になってしまいます。料理と同じで、素材が悪ければ三ツ星シェフでも美味しいフレンチは作れないんです。
予測精度を決める特徴量の作り方
データサイエンスの世界には「Garbage In, Garbage Out(ゴミを入れたらゴミが出てくる)」という有名な格言があります。
これは、どんなに最新のアルゴリズムを使っても、入力するデータセットの質が悪ければ、マシンの演算能力を無駄遣いするだけで、結果も全く使い物にならないという意味です。
競馬予想AIの開発においても、まさにこれが勝敗を分ける最大のキーポイントになります。実は、JRAから提供される「走破タイム」「着順」「馬体重」といった生のデータを、そのままポンッとAIに放り込んでも、高い予測精度は得られないんです。
生データをAIの「好物」に調理する職人技
ここで重要になるのが、「特徴量エンジニアリング(Feature Engineering)」と呼ばれる魔法のプロセスです。
これは、生データをAIが意味を理解しやすく、そして関係性を見出しやすい形に加工・変換・合成する「職人技」のことです。
例えば、人間のプロ予想家は、馬柱(新聞のデータ)を見ながら無意識のうちに「この馬、前走はタイム遅いけど、重馬場だったからノーカンだな」とか「馬体重がプラス10キロだけど、成長分だからむしろプラスだな」といった高度な脳内補正を行っていますよね。
この「人間の熟練予想家が無意識に行っている判断プロセス」を数字の数式に置き換えて、AIに教えてあげる作業が特徴量エンジニアリングなんです。
| 特徴量の種類 | 具体的な生成ロジックと、競馬AIにおける分析意図 |
|---|---|
| 相対的順位・偏差値 | 走破タイムや上がり3ハロンのタイムを「何分何秒」という絶対値ではなく、そのレースの出走メンバー内での「偏差値(相対評価)」に変換します。 競馬場や当日の馬場状態(良、重、不良など)によってタイムの基準は全く異なるため、絶対値のまま入力するとAIが「タイムが遅い=弱い」と誤認してしまうのを防ぐためです。 |
| 体重変化率(BMI化) | 単純な増減(+4kgなど)ではなく、前走からの増減を当日の馬体重で割った「変化率」を算出します。 体重400kgの小柄な牝馬にとっての「+10kg」と、550kgの巨大なダート馬にとっての「+10kg」では、身体に与える影響や意味合いが全く違いますよね。コンディション変動をより正確にAIに捉えさせるための工夫です。 |
| 騎手の位置取りバイアス | 「騎手の平均的な位置取り」から「その馬の過去の平均位置取り」を引き算して数値化します。 値がマイナスなら、その騎手は「馬の本来の脚質よりも、無理をしてでも前に行きたがる積極策をとる傾向がある」という意味になり、レースのペース展開(ハイペースになるか等)の予測に直結します。 |
| コース固有特性の数値化 | 単に「東京芝2400m」という文字ラベルを貼るだけでなく、「直線距離の長さ」「高低差のメートル」「コーナーの数」「内外回りのフラグ」といった物理的な数値を定数として追加します。 これを血統データと掛け合わせることで、潜在的なコース適性をAIに認識させます。 |
どうですか? 少し専門的ですが、こうやって人間が丁寧にデータを下ごしらえしてあげることで、初めてAIは本来のパワーを発揮して、人間が気づかないような微細な相関関係を見つけ出してくれるようになるんです。
レースの相対的な順位を予測する手法
少し前までの競馬AI開発では、AIに何を予測させるか(目的変数と言います)を設定する際、「この馬が3着以内に入るか、入らないか」という二択(二値分類)や、「ゴールまでの走破タイムが何秒になるか」という絶対値を予測させる手法が主流でした。
でも、実際にAIを運用していく中で、このアプローチには「競馬というスポーツの本質からズレている」という構造的な欠陥があることが分かってきたんです。
競馬の本質は「タイムトライアル」ではない
冷静に考えてみてください。競馬って、みんなでよーいドンして、タイムの速さを競う陸上競技や水泳のようなスポーツではありませんよね。
いくら持ちタイムが速くても、前の馬が壁になって抜け出せなければ負けますし、逆に全体的にめちゃくちゃ遅いスローペースのレースでも、周りより少しだけ速い脚を使えれば1着になれます。
つまり、競馬の本質は「絶対的なタイムを競う」ものではなく、一緒に出走している他の馬たちと比べて、「相対的に前にいるか、後ろにいるか」という並び順(ランキング)を競うゲームなんです。
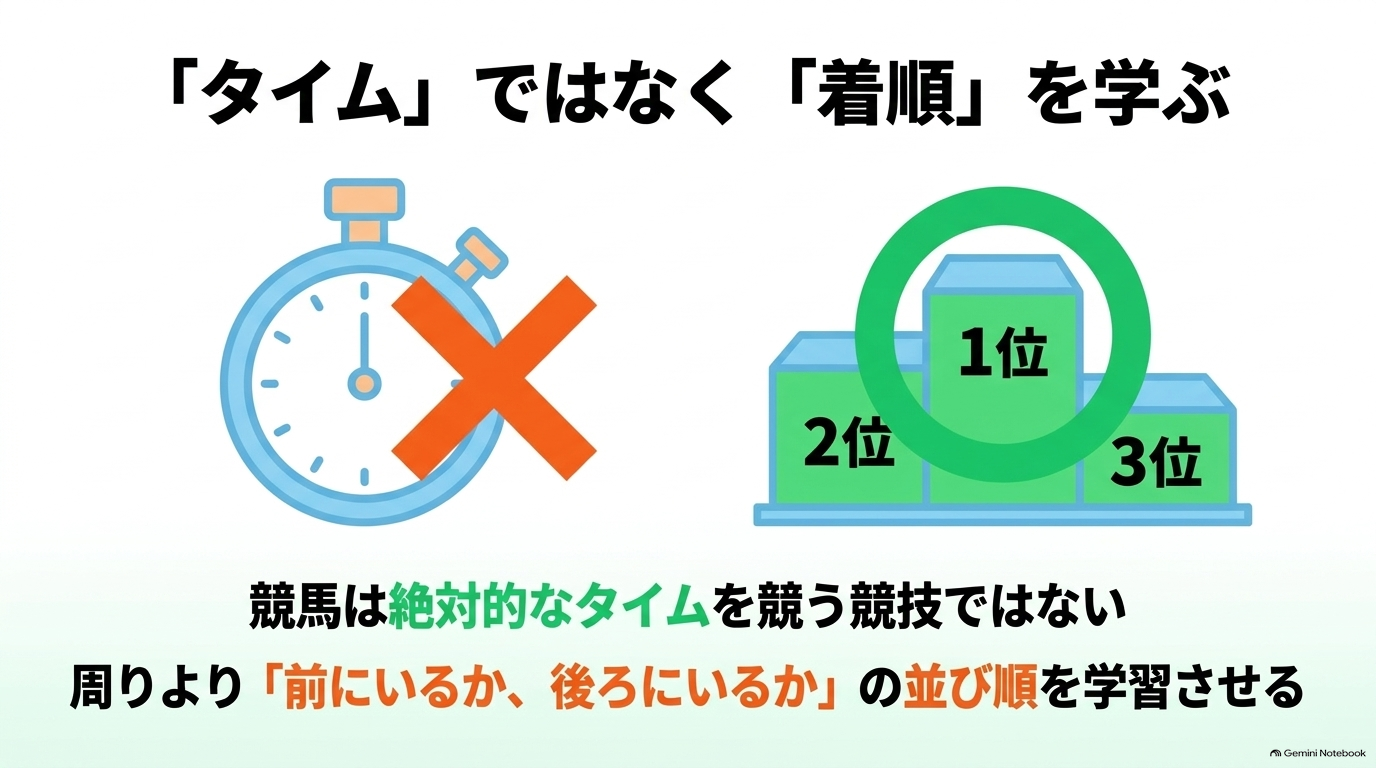
タイムの絶対値ではなく相対的な着順を予測する競馬AIの仕組み
しかも、二値分類(3着以内か否か)で学習させると、AIは「1着の馬を当てること」と「ブービー(最下位から2番目)の馬を当てること」を、計算上同じ価値として扱ってしまいます。馬券を買う私たちからすれば、1着を当てるのと最下位を当てるのとでは、価値が天と地ほど違いますよね。
そこで最近の高度な競馬 ai 予想では、「ランキング学習(Learning to Rank)」、特に後述するLightGBMに実装されている「LambdaRank(ラムダランク)」というパラダイムシフト(革新的な手法)が注目されています。
これは、GoogleやAmazonの検索エンジンが「どのウェブサイトや商品を一番上に表示するか」を最適化するのと同じ仕組みです。
「馬Aは馬Bよりも上に来る確率が高い」という相対的な関係性をAIに学習させ、予測結果が上位であるほど(正解が1着や2着に近いほど)評価を高くする仕組みを持っています。
このランキング学習を取り入れることで、実際の競馬のレース展開にものすごく近い、自然で高精度な着順予測モデルが作れるようになったんです。
データリークなどの落とし穴に注意
さて、データ分析の話をすると、競馬AI開発者が必ずぶち当たる恐ろしい落とし穴があります。時に数ヶ月かけて組み上げたプログラムを、一瞬で水泡に帰す(無駄にしてしまう)ほどの絶望的なミスです。
それが「データリーク(Data Leakage:未来情報の漏洩)」という現象です。
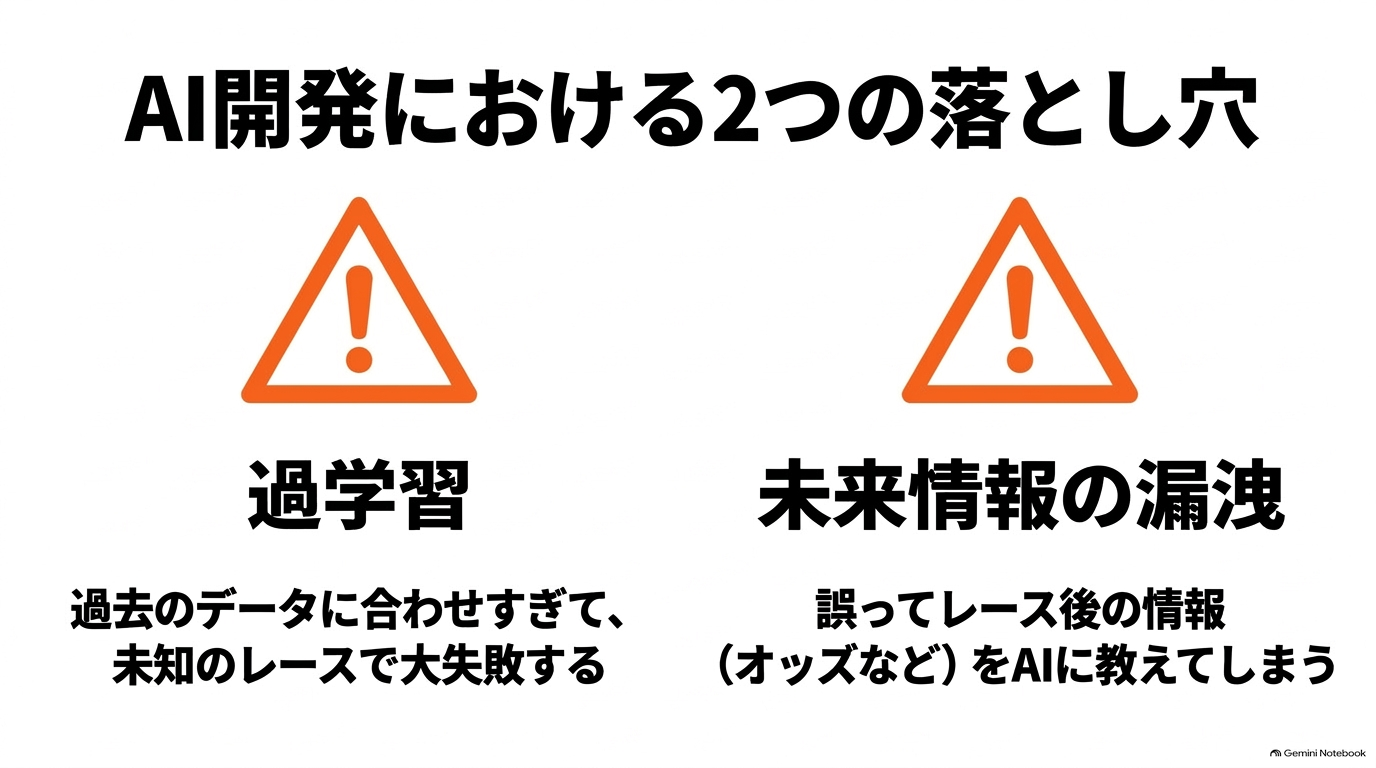
競馬AI開発における過学習と未来情報の漏洩への注意喚起
言葉の通り、予測時点(つまりレースが発走する前の時点)では絶対に知り得ない「未来の情報」が、誤ってAIの訓練用データの中に混入してしまう現象を指します。
答案を横目で見ながらテストを解くAI
ある開発者の記録によると、試作段階のAIのバックテスト(過去のデータを使った模擬運用)で、複勝の期待値戦略が「回収率211%」というとんでもない数値を叩き出したことがあったそうです。
控除率が20%も引かれる市場で、長期的に200%を超える回収率を出すなんて、どう考えても不自然ですよね。ノーベル賞ものの発明です。
◆YUKINOSUKEのワンポイントアドバイス
おかしいと思って詳細に調査した結果、このAIはなんと学習データとして「レース確定後の払戻表から取得した確定オッズ」を使ってしまっていたことが判明しました。
確定後の複勝オッズって、「他にどの馬が3着以内に入ったか」というレース結果の答えがモロに反映されている数値なんです。
つまりこのAIは、実力で未来を予測したわけではなく、「答案用紙を横目で見ながらテストを解いていた」だけだったんです。発走前に入手可能なデータだけに直して再計算したら、あっけなく回収率は80%台に落ちたそうです。AIあるあるの怖い話ですよね。
他にも、前走からの累積データ(平均着順など)を計算する時に、うっかり「その日のレース結果」を含めて計算してしまったり、レース中に骨折などで競走中止になった馬のデータを無視して計算してしまったりと、データリークのワナは至る所に潜んでいます。(レース前に「この馬は今日骨折する」なんて誰にも分かりませんからね)。
時系列交差検証(Time-Series Split)の重要性
さらに、AIの性能をテストする「交差検証(Cross-Validation)」の段階でもリークは起きます。
一般的なAI開発では、データをランダムに分割してテストする手法(K-Fold交差検証など)がよく使われます。しかし、これを競馬データでやってしまうと、「2023年の未来のレース結果を学習したAIが、2021年の過去のレースを予測する」という、タイムマシンを使ったタイムパラドックス状態が発生してしまいます。
これではAIが「未来の傾向」をすでに知っている状態で過去を予測するため、見かけ上の精度が異常に高く出てしまい、本番で全く役に立たないモデルになってしまいます。
競馬データ分析においては、時間の順序を厳格に守り、「必ず過去のデータだけで学習し、未来のデータでテスト検証する」という時系列交差検証(TimeSeriesSplit)を適用することが絶対条件になります。ここで手を抜くと、週末の競馬場で痛い目を見るのは自分自身ですからね。
競馬lightgbmが最強のアルゴリズム
データリークという恐ろしい落とし穴を回避し、綺麗に下ごしらえされた完璧なデータを準備できたとしましょう。次はいよいよ、そのデータを読み込ませて「予測モデル」を作るためのエンジン(アルゴリズム)の出番です。
AIや機械学習の世界には、「ニューラルネットワーク(ディープラーニング)」「ランダムフォレスト」「サポートベクターマシン」など、目的に応じて様々な必殺技のようなアルゴリズムが存在します。
でも、こと「競馬のデータ分析」というジャンルにおいて、現在世界中のデータサイエンティストや競馬AI開発者から「実質的な業界標準(デファクトスタンダード)」として圧倒的な支持を集めている最強のアルゴリズムがあります。
それが、今回のフォーカスキーワードでもある「競馬 lightgbm(ライト・ジービーエム)」です。ここでは、なぜLightGBMが競馬予想において無双状態にあるのか、その秘密に迫っていきます。
競馬AIと相性が良い理由とその特徴
LightGBMは、Microsoft社が中心となって開発した「勾配ブースティング決定木(Gradient Boosting Decision Tree:GBDT)」と呼ばれる機械学習の手法の一つです。 (出典:Microsoft Corporation『LightGBM Official Documentation』)
「決定木」というのは、データを「Yes/No」の条件分岐で連続的に振り分けていって、最終的な答えにたどり着くアプローチのことです。アキネイターという、質問に答えていくと思い浮かべたキャラクターを当ててくれるゲームがありますよね?あんなイメージです。
「前走の上がり3ハロンのタイムはメンバー中3位以内か?(Yes / No)」
「今回のレース距離は、血統的に得意な距離か?(Yes / No)」
「前走から馬体重はプラス体重か?(Yes / No)」
こういった条件分岐を何千、何万という規模で複雑に組み合わせていくんです。では、なぜこのLightGBMが、他のアルゴリズム(例えば、画像認識などで有名なディープラーニングなど)を差し置いて、競馬予想の分野で最強と言われているのでしょうか?
1. 競馬特有の「表形式データ」にめちゃくちゃ強い
ディープラーニングは、画像や音声、自然言語(文章)などの複雑なデータを処理するのは大の得意です。しかし、競馬のデータのように、エクセルの表のように綺麗に項目が分かれているデータ(表形式データ・構造化データ)の分析においては、実は決定木ベースのアルゴリズムの方が精度が高くなりやすいという特徴があります。
タイム、着順、オッズ、斤量といった数値データと、血統、騎手、競馬場といったカテゴリデータが複雑に混ざり合う競馬の世界では、LightGBMの処理能力がピタリとハマるんです。
2. 「Leaf-wise(葉ごと)」の成長方式がもたらす圧倒的な表現力
LightGBMが他の決定木アルゴリズム(XGBoostなど)に対して優位性を持っている最大の理由は、「Leaf-wise Tree Growth(葉ごとの分割方式)」という独特の成長システムを採用している点にあります。
従来のアルゴリズムは、条件分岐のツリーを作る時に、浅い階層から順番に「全体をバランスよく」均等に分割して成長させていくのが普通でした(Depth-wise方式)。
しかしLightGBMは違います。全体のバランスなんて気にせず、「一番予測の誤差が減りそうな条件(損失の低減効果が最も高い葉)」だけをターゲットにして、そこだけを優先的に、深く深く、マニアックに掘り下げて分割していくんです。
競馬って、「基本的には弱い馬なんだけど、東京競馬場の芝2400mで、しかも前日が雨で馬場が少し荒れていて、かつ特定の種牡馬の血を引いている時にだけ、突然化け物のように激走する」みたいな、特定の条件が複雑に絡み合った時だけ発動する「ニッチな適性」が隠れていますよね。
LightGBMの「一点集中で深く掘り下げる」仕組みは、こういった競馬データに潜む「複雑で非線形な相互作用」を、極めて精緻に、そして鮮やかにあぶり出すことができるんです。これが競馬AIと最高に相性が良い理由です。
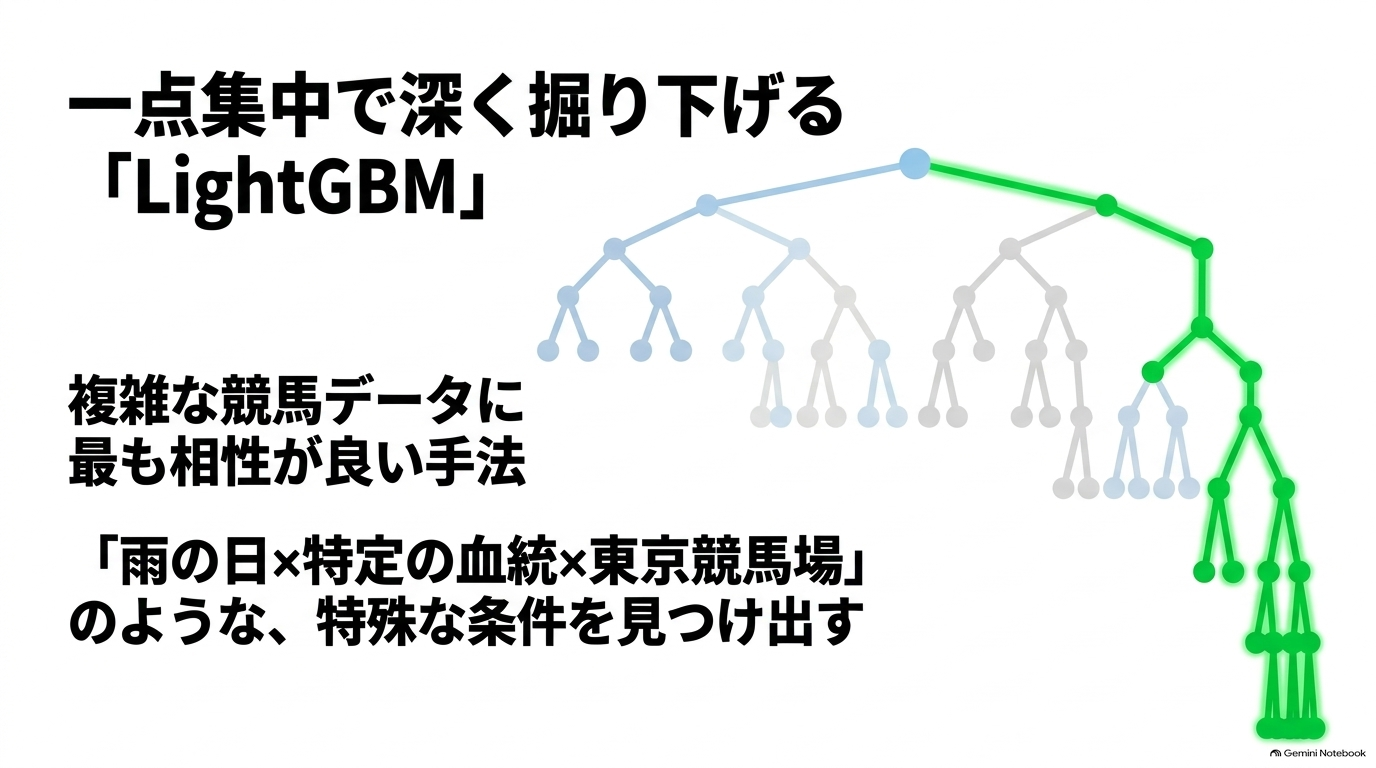
複雑な競馬データと相性の良いLightGBMの条件分岐アルゴリズム
3. 計算スピードが異常なほど速い
過去数十万レースのデータを処理させるとなると、普通のアルゴリズムでは計算に何日もかかってパソコンがフリーズしてしまいます。しかしLightGBMは、連続する数値を「ビン」と呼ばれる大まかな箱に分けて計算する(ヒストグラムベース)など、演算コストを劇的に下げる革命的な技術が盛り込まれています。
これにより、信じられないほどの高速学習を実現し、週末の限られた時間の中でも、最新のオッズや馬体重を取り込みながらリアルタイムでモデルを更新していくことが可能になっています。
過学習を防ぐための最適なチューニング
ここまで聞くと「LightGBMって完璧じゃん!」と思うかもしれません。しかし、天才には天才なりの弱点があります。
LightGBMは、Leaf-wise方式で「深く掘り下げる」のが得意すぎるあまり、過去の訓練データにピッタリと適合しすぎてしまう「過学習(Overfitting)」という大問題を常に抱えているんです。
過学習(オーバーフィッティング)とは?
過去のレース結果を、まるで丸暗記するように完璧に学習してしまう状態のことです。
過去のテストの過去問の答えだけを丸暗記した学生が、いざ本番の試験で少しだけ問題の言い回しを変えられた途端に、パニックになって0点を取ってしまうのと同じです。
過学習に陥ったAIは、過去のデータでのテストでは「回収率150%!」という素晴らしい成績を出しますが、いざ未知のレース(今週末の新しいレース)を予想させると、応用が全く利かずにボロボロに外しまくります。
この過学習を防ぎ、未知のレースに対する「対応力(汎化性能)」を持たせるためには、AIの開発者が「ハイパーパラメータ」と呼ばれるAIの設定値を、手作業(またはOptunaなどの自動最適化ツール)で職人のように微調整していく必要があります。
では、具体的にどんな設定をいじっているのか、少しだけAI開発の裏側を覗いてみましょう。
| パラメータ名 | 役割と、AIの性格をどう変えるか |
|---|---|
| num_leaves (葉の最大数) |
1つの決定木がどこまで複雑な条件分岐(葉っぱ)を持てるかの限界値です。 この数値を大きくしすぎると、モデルが複雑になりすぎて過去データに依存(過学習)しやすくなります。あえて制限を設けることで、AIに「大局を見る余裕」を与えます。 |
| learning_rate (学習率) |
AIが間違いから学習する「歩幅」の広さです。 数値を小さく(例えば0.03など)設定すると、時間はかかりますが、ゆっくりと確実にデータを学習し、精度の高い手堅いモデルに仕上がります。 |
| feature_fraction (特徴量の抽出率) |
AIが学習する際に、用意したすべてのデータ(特徴量)を使わせるのではなく、例えば「ランダムに80%だけ使え」と意図的に情報を隠す設定です。 一部の強力なデータ(例:特定の騎手情報など)にだけ依存して判断するのを防ぎ、AIの視野を広げて柔軟な思考をさせることができます。 |
| lambda_l1 / lambda_l2 (正則化) |
予測にあまり影響がない無駄なデータの影響力を強制的にゼロに近づけたり(L1)、特定のデータに極端に重み付けが偏るのを抑え込んだり(L2)するブレーキの役割です。これでモデルをシンプルに保ちます。 |
実は、このハイパーパラメータの数値を少しイジるだけで、AIの「性格」や「馬券の買い方の戦略」が劇的に変化するんです。
◆YUKINOSUKEのワンポイントアドバイス
あるAI開発者の方の実験記録を読んだことがあるんですが、設定の閾値を少し変更しただけで、「的中率45%だけど、ガチガチの堅い本命馬しか買わなくなり、結果的に回収率が84%に落ちたAI」になったり、逆に「万馬券ばかりを無理やり狙う設定にしたら、的中率がたったの0.6%になってしまい、資金が溶けまくるAI」に転落したりしたそうです。
最終的に、的中率を7%程度に割り切り、平均オッズ18倍くらいの中穴をコツコツ拾い続けるバランス(期待値の差を安定させるライン)を見つけ出して、回収率100%超えを達成していました。AIを育てるのって、子育てみたいで本当に奥が深いんですよ。
競馬予想AIの注意点と正しい心構え
ここまで、AIがいかに高度なデータ分析を行い、LightGBMという最強の武器を使って予測を立てているか、その素晴らしい可能性についてお伝えしてきました。
「よし、AIの仕組みはだいたいわかった!あとは回収率100%超えのAIの言う通りに馬券を買い続ければ、寝ていても自動的にお金が増えるぞ!」
……と思ったあなた。ちょっとだけ待ってください。両手で思いっきりストップをかけさせてください。
競馬という、不確実性(運の要素)が極めて強く絡む世界において、「絶対」という言葉は存在しません。最後に、AI予想を安全に、そして賢く使いこなすための、大人として絶対に忘れてはいけない大切な心構えをお伝えしますね。
オッズの複雑さと確率の歪みを知る
まず大前提として、AI(LightGBM)が計算して出力した「この馬が勝つスコア」を、厳密な意味での「実確率(本当の勝率)」としてそのまま鵜呑みにしてはいけません。
実は、分類アルゴリズムが出力する生え抜きの数値には、AI特有の「歪み」が含まれているんです。
競馬のように「強い馬(1番人気など)は少数で、勝てない馬(大穴)がたくさんいる」というアンバランスなデータを学習させると、AIはどうしても以下のような癖を持ってしまいます。
- 1番人気のような、元々勝つ可能性が高い馬の確率を、実際よりもさらに過大に評価してしまう(例:本当は勝率20%なのに、AIは30%と出力する)。
- 逆に、穴馬のような勝つ可能性が低い馬の確率を、実際よりも過小に評価してしまう(例:本当は勝率5%あるのに、AIは1%しか無いと出力する)。
このAIの出力のズレを放置したままオッズと掛け合わせて期待値を計算すると、「穴馬の期待値が極端に低く算出され、妙味を見逃してしまう」という致命的なミスが発生します。
そのため、本気で実運用される競馬AIでは、AIが出力した数値を「真の勝率」へと真っ直ぐに補正するための「確率の校正(キャリブレーション)」という非常に高度な数学的処理(重み付き保序回帰など)を必ず行っています。ネットに落ちている無料の簡単なAI予想は、この補正をサボっていることが多いので注意が必要です。
複勝オッズの期待値計算は「地獄のパズル」
さらに私たちを悩ませるのが、「複勝」や「ワイド」「三連複」といった、複数の馬が絡む馬券の期待値計算の複雑さです。
単勝馬券なら、「AIの出した真の勝率 × 単勝オッズ」という単純な掛け算で期待値が出ます。
しかし、複勝馬券のオッズって、「1.5倍〜2.3倍」のように幅を持たせて表示されていますよね。あれはなぜかと言うと、日本のパリミュチュエル方式においては、「一緒に3着以内に入った他の2頭が、人気馬だったか、不人気馬だったか」によって、自分に支払われる払戻金のオッズがダイナミックに変動するからです。
つまり、AIを使って複勝馬券の「本当の期待値」を計算するためには、狙っている馬が3着以内に入る確率だけではなく、「他のすべての出走馬の組み合わせパターン」をシミュレーションし、それぞれのパターンで形成される推定オッズを掛け合わせて総和を求めるという、金融派生商品のプライシング(価格付け)にも匹敵する超絶怒涛の計算が必要になります。
AI予想を使う時は、そのAIが「単勝だけを狙う仕様」なのか、「複勝やワイドの複雑なオッズ変動まで見越して計算している高度なシステム」なのかを、しっかりと見極める目を持つことが大切です。
破産を防ぐための徹底した資金管理
どんなに精度の高い競馬予想aiを見つけて、キャリブレーションも完璧に行い、「よし、この馬はオッズ20倍つくのに勝率が10%もある!期待値は驚異の200%だ!」というお宝馬を発見したとします。
しかし、それで自動的にお金持ちになれるわけではありません。なぜなら、期待値がプラスであっても、「確率の下振れ(分散)」という恐ろしい現象が必ず待ち受けているからです。
サイコロを振って「1」の目が出る確率は1/6ですが、6回振れば必ず1回出るわけではありませんよね。運が悪ければ、20回振っても30回振っても「1」が出ないことだって、数学的には普通に起こり得ます。
競馬も同じです。勝率10%のお宝穴馬を買い続けても、運悪く20連敗、30連敗の波(ドローダウン)に巻き込まれることは日常茶飯事です。
「全ツッパ」は破産への特急券
もしあなたが、軍資金10万円を持っていて、「期待値が200%もあるから大勝負だ!」と1レースに5万円を賭けてしまったらどうなるでしょう。
勝率10%なら、高い確率でそのレースは外れます。次のレースも外れたら、そこでもう資金はゼロ(破産)です。期待値が収束する(本来の確率通りになる)前に、ゲームオーバーになって退場させられてしまうんです。
ここで最も重要になるのが「資金管理(バンクロール管理)」という概念です。
プロが使う「ケリー基準」と現実的なルール
投資の世界には、勝率とオッズから「現在の自分の総資産の何パーセントを賭けるのが、最も効率よく、かつ破産せずに資金を増やせるか」を算出する「ケリー基準」という数学的な公式があります。
ただ、ケリー基準の計算通りに賭けると、AIの勝率予測にわずかでも誤差があった場合、過剰な金額を賭けてしまってリスクが跳ね上がる「諸刃の剣」になってしまいます。
そのため、現実の実務レベルでは、算出された金額の何分の一かに抑える「フラクショナルケリー(ハーフケリーやクォーターケリー)」と呼ばれる手法がよく使われます。
初心者の方に絶対に守ってほしいルールは、「どんなに自信があるレースでも、手持ちの軍資金総額の2%〜5%以上は絶対に1レースに投じない」ということです。
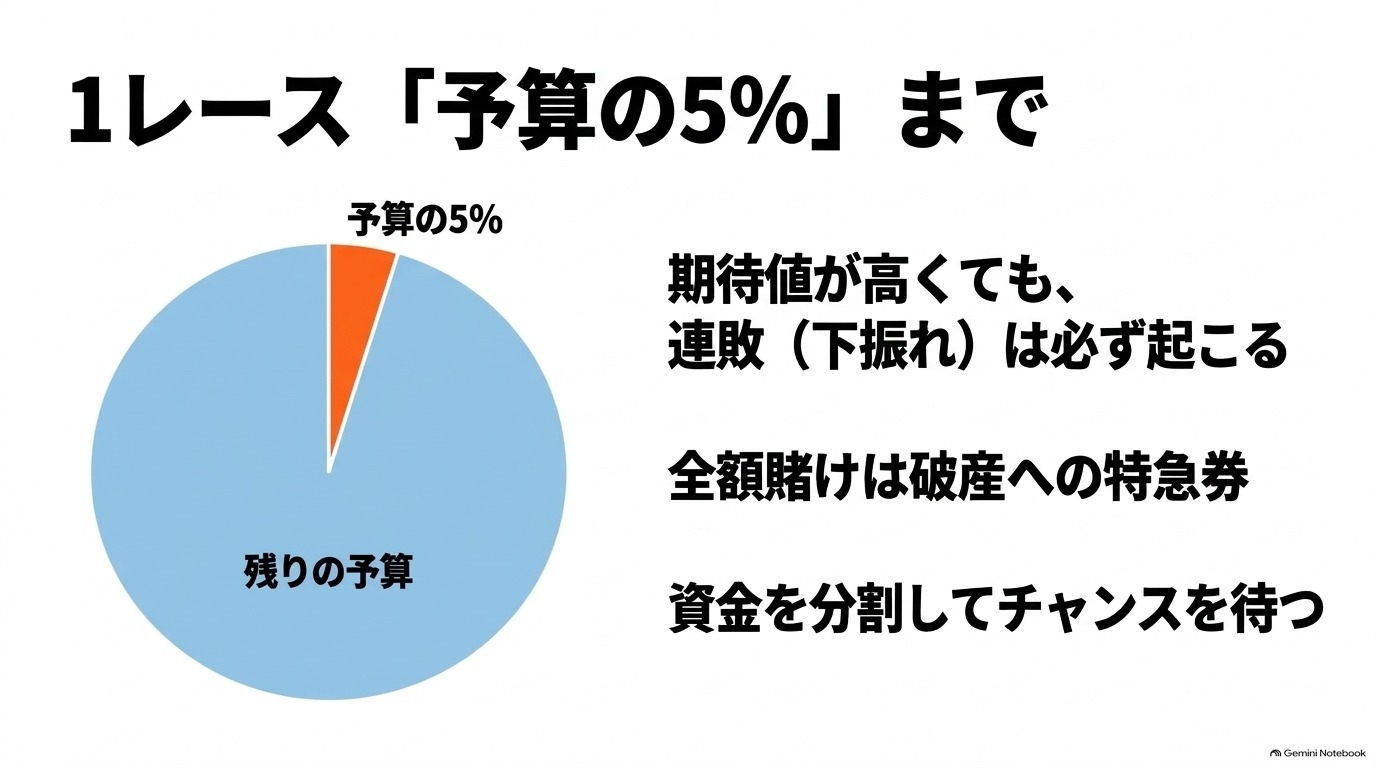
連敗による破産を防ぐための徹底した競馬の資金管理ルール
10万円の予算なら、1レース最大でも2000円〜5000円まで。これなら、仮に20連敗しても資金は半分残りますから、落ち着いて次のチャンスを待つことができます。
また、せっかく予想が当たっても、買い目の点数が多すぎて払い戻しが投資額を下回ってしまう「トリガミ」を防ぐ買い方を学ぶことも重要です。
点数をスマートに絞って賢く買うテクニックについては、私が以前書いた👉 競馬のボックス買いとは?点数が増える仕組みと注意点 の記事もぜひ参考にしてみてくださいね。これを知っているだけで、資金の持ちが全然違いますよ。
予想AIはあくまで補助ツールに留める
AIは、過去のデータを分析して冷徹に確率を計算してくれます。その能力は、人間の処理能力を遥かに凌駕しています。それは紛れもない事実です。
しかし、競馬は机上の計算だけで決まるものではありません。生身の感情を持ったサラブレッドが懸命に走り、プレッシャーを感じる生身のジョッキーが手綱を握り、自然の天候の中で行われる、極めてフィジカルでドラマチックなスポーツです。
スタート直後にゲートの中で馬が立ち上がってしまったり、道中で前の馬が壁になって進路が塞がれたり、レース直前に突然のゲリラ豪雨で芝が田んぼのようになったり……。
こういった「当日の突発的なアクシデント」や「パドックでの馬の機嫌の良し悪し」までは、過去の数字だけを食べているデータAIには完全には読み切れません。(最近はLLMを使って当日のパドック解説者のコメントをテキスト分析するアプローチも始まっていますが、まだまだ発展途上です)。
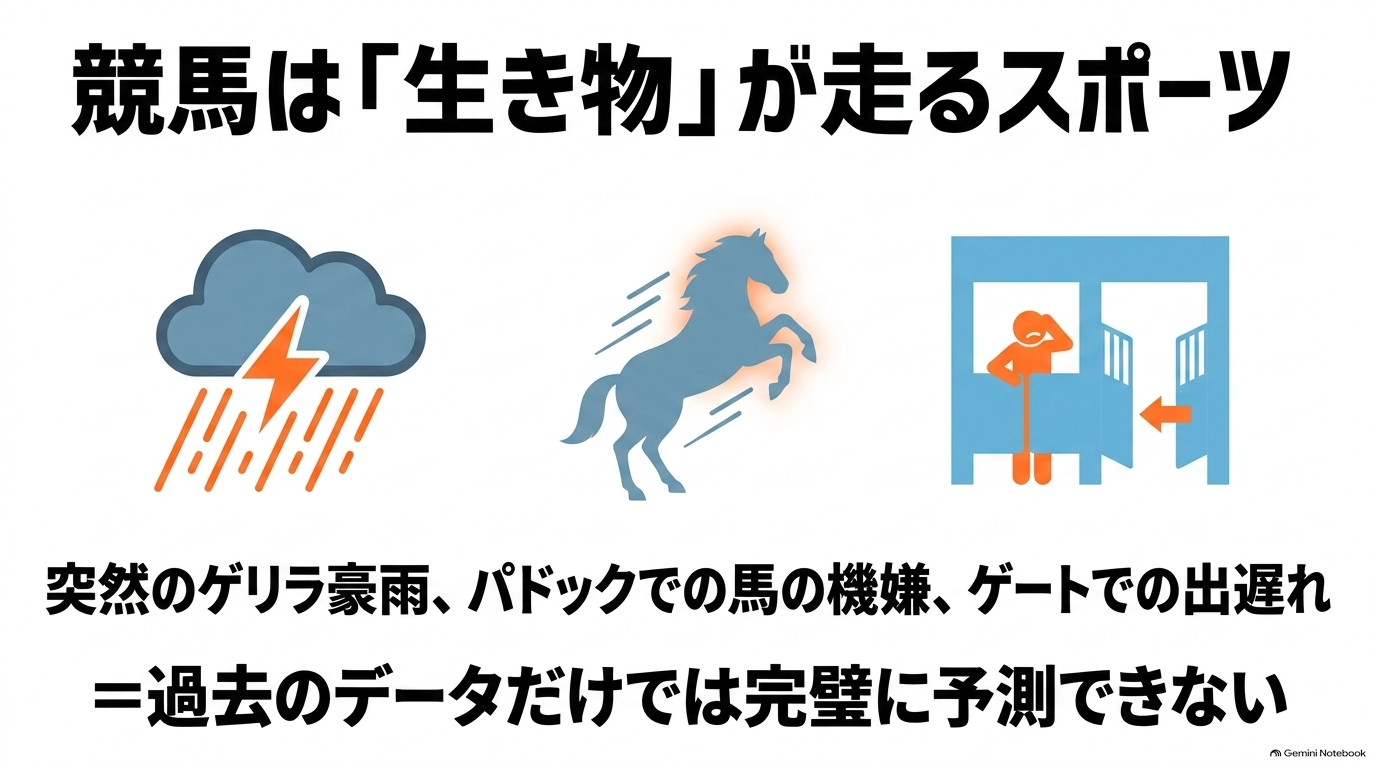
天候や馬の機嫌などデータだけでは完璧に予測できない不確定要素
自分で考える楽しさを手放さないで
AIの予想は、「絶対の神のお告げ」として盲信するのではなく、「自分では気づけなかったオッズの歪みや、穴馬の存在を教えてくれる、ものすごく頭のいい有能なパートナー」くらいに思っておくのが一番健全です。
AIが弾き出した客観的なデータに、あなた自身の目で見たパドックの雰囲気や、その日の競馬場の生の空気感、そして「この馬に勝ってほしい!」という競馬ファンとしてのロマンをほんの少しだけスパイスとして振りかける。
そして、最終的な決断のハンコは、必ず自分自身で押す。外れたら自分の責任、当たったら自分の手柄。
それこそが、競馬を「やらされるギャンブル」ではなく、大人が本気で熱中できる「最高のエンターテインメント」として一生楽しむための秘訣かなと思います。
最終的な予想は自分の頭で考える知的エンターテインメントとしての競馬
もし今週末、現地(競馬場)での観戦を予定しているなら、発走直前のイライラする発売機の行列に並ばず、スマホでサクッとスマートに馬券が買える👉 スマッピー投票とは?競馬場でのQR投票の使い方を初心者向けに解説 の記事や、パソコンを開いて快適に予想に集中できる👉 競馬場の座席・指定席・VIP席の違い の記事も合わせてチェックして、準備万端で最高の週末を迎えてくださいね!
競馬AI予想に関するよくある質問(FAQ)
Q1. 競馬AI予想を使えば絶対に儲かりますか?
A. 福祉業界で誠実さをモットーに働いている私から、はっきりとお伝えします。「絶対に儲かる」という保証はこの世のどこにもありません。
AIはあくまで過去のデータから「確率の高い選択肢(期待値)」を提示する強力なツールですが、競馬には生き物が関わる予測不可能な不確定要素が常に存在します。オッズの急変動や、数学的に必ず訪れる連敗の波(下振れリスク)もあるため、あくまで予想を組み立てるための「参考データ」程度に留めてください。最終的な馬券の購入判断は、必ずご自身の自己責任で行うようお願いいたします。
Q2. 無料のAI予想サービスと有料のサービスでは、明確な違いがありますか?
A. はい、内部のアルゴリズムや狙いに大きな違いがあることが多いです。
SNS等で見かける無料のものは、単純に「1番当たりやすい馬(つまり人気馬)」をそのまま出力して的中率だけを追っているケースが目立ちます。これでは控除率の壁を越えられません。
一方、本格的な有料サービス(VUMAやSPAIA競馬など)は、「オッズに対する期待値」を緻密に計算し、長期的な回収率を高めるための複雑なアルゴリズム(妙味馬の抽出やマルチエージェント方式など)を搭載していることが多いです。ただし、有料だからといって必ず勝てるわけではないので、まずはご自身の予算と相談して決めてみてください。
Q3. パソコン素人の私でも、LightGBMを使って競馬AIを自作できますか?
A. Pythonなどのプログラミングの基礎知識や、JRA-VANデータラボからのデータ取得方法をゼロから学べば、個人でも自作することは十分に可能です。今はネット上に有志の開発記録がたくさん公開されています。
ただ、本文でも解説したデータリークの防止や、ハイパーパラメータの調整、何より精度を上げるための「データクレンジングと特徴量エンジニアリング」には、途方もない根気と試行錯誤が必要になります。「競馬の予想」というより「データサイエンスの研究」に近い作業になるので、それを楽しめる方には最高の知的趣味になると思いますよ!
Q4. AIを信じて、生活費や高額な資金を馬券に突っ込んでも大丈夫でしょうか?
A. 絶対に、絶対におすすめしません。どんなにAIの予測精度が高く、期待値がプラスであっても、確率のブレによる「不的中(連敗)」は必ず発生します。
投資額を誤ると一瞬で資金が底を突き、生活が破綻してしまいます。競馬はあくまでレジャーです。必ずご自身のお小遣いの範囲内、仮に全額無くなっても生活に全く支障のない金額で楽しむようにしてください。
もし、ギャンブルへののめり込みに不安を感じる、自分をコントロールできないといった場合は、一人で抱え込まず、ご家族や専門家、あるいは公的な相談機関(消費者センターや依存症窓口)に必ずご相談くださいね。長く楽しむための安全第一です。
まとめ
大変長らくお付き合いいただき、本当にありがとうございました!いかがでしたでしょうか?
今回は、昨今話題沸騰中の競馬 aiについて、その基本的な仕組みから、データをどうやって調理・分析しているのか、そして競馬の世界で最強と呼ばれるアルゴリズム競馬 lightgbmの凄さと過学習のワナまで、基礎的な部分をギュギュッと濃厚にまとめてお伝えしました。
AIは、過去の膨大なデータを瞬時に処理し、私たちの「好き嫌い」や「思い込み」といった邪魔な感情を排除して、冷徹に「期待値」を教えてくれる、本当に素晴らしい技術の結晶です。
しかし、この記事を通してお伝えしてきたように、AIは振ればお金が出てくる「魔法の杖」ではありません。
重く立ちはだかる控除率の壁、予測不可能な当日のアクシデント、そして何より、連敗の波が来た時にメンタルを試される「資金管理」。最終的にこれらの困難を乗り越えていくのは、他の誰でもない、あなた自身の「冷静な判断力」と「自制心」なんです。
私は普段、福祉の現場で「誠実さ」をモットーに働いていますが、競馬の世界にも同じように誠実に向き合いたいと思っています。だから、「これを使えば簡単に儲かる!」なんて嘘は絶対につきません。
AI予想はあくまでも「データ分析を助けてくれる、とびきり優秀な相棒」として横に置いておく。そして、パドックの雰囲気や騎手の駆け引きを加味して、最後の買い目はご自身の頭で納得して決める。
それが、長く、楽しく、そして知的に競馬というスポーツと付き合っていくための最高のスタンスだと私は確信しています。
さあ、ロジカルな思考という最強の武器を手に入れたあなた。もう、オカルトや他人の印に振り回されるだけの週末とは今日でお別れです。
無理のない予算でしっかり資金をコントロールしながら、今週末もあなたにとって最高のスタジアムエンターテインメントを楽しんでいきましょう!
もし今回の記事が少しでも参考になったら、ぜひ当ブログをブックマーク(お気に入り登録)して、今週末の予想の際にもう一度遊びに来てくださいね。北海道の空の下から、YUKINOSUKEがいつでもお待ちしています!


コメント